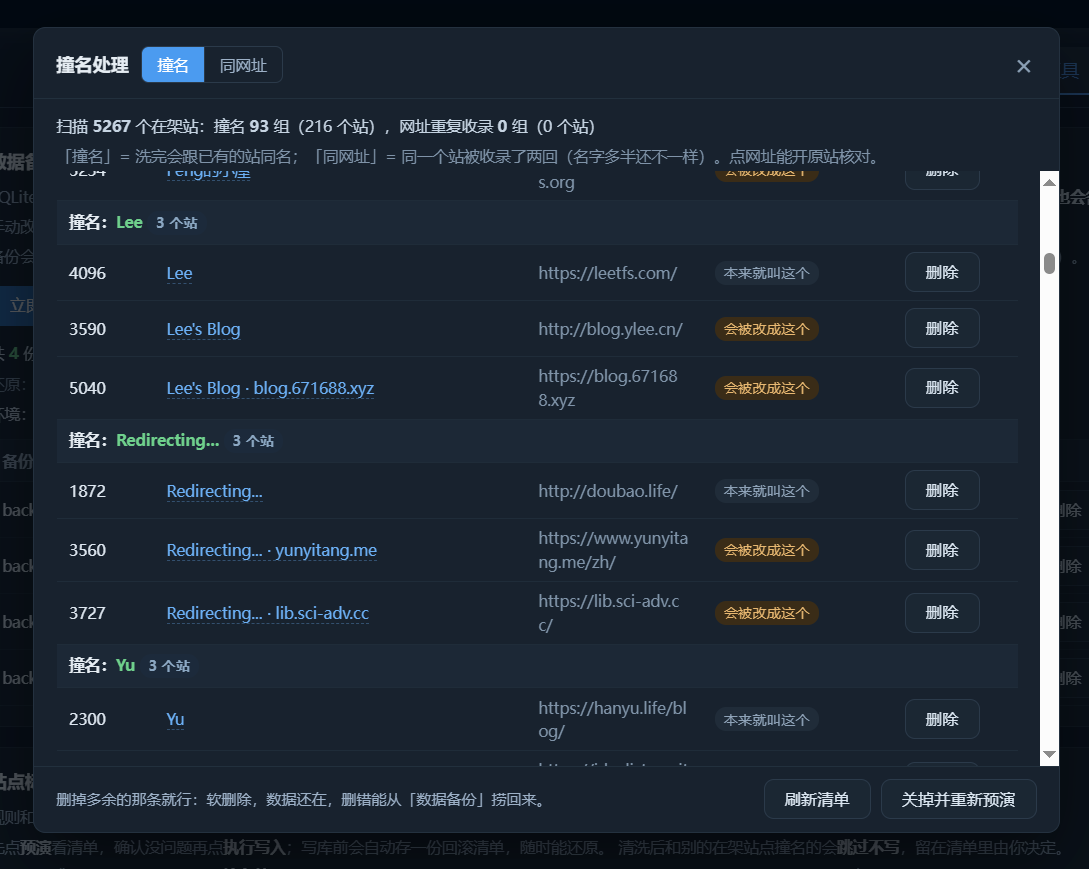
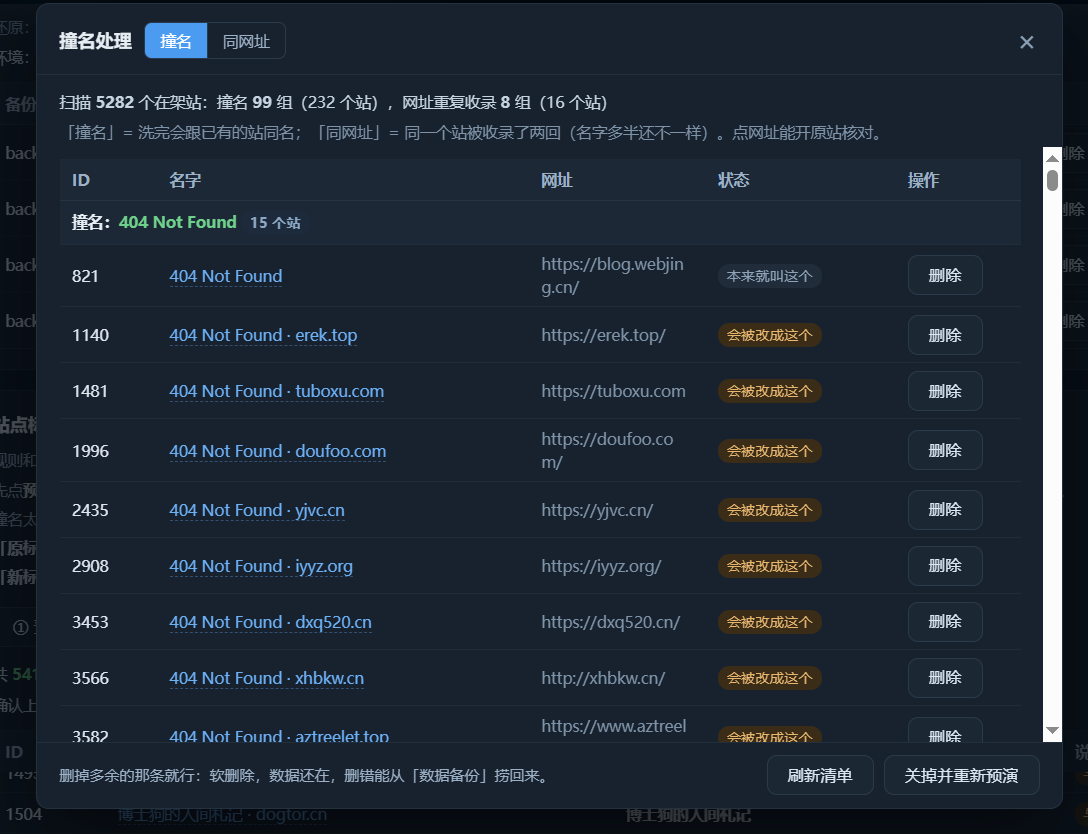
阅联这两天进入数据蒸馏了,如何让数据规范和质量高些,是个大难题,首先遇到的难题是,网站标题的问题,批量AI采集的时候没有完美的过滤,采集到的网站标题多数带有网站介绍及各种符号,比较长,多数还撑满了页面,显示在网站广场超级难看,这我肯定忍不了的。
再有就是为了跟随我说的那个让阅读和记录更有动力,网站卡片新增了网站年龄,且很鲜明的显示在卡片上,让阅读的人知道,哇,这网站已经20多年了,顿时羡慕产生自己也要记的积极观感。字段添加很简单,但是这个年龄怎么算,尝试人工找,一个是从底部版权博主标的时间,一个是从归档的最早文章来算。
这两玩意已经折腾了我两天,因为每天有1小时多些的RSS阅读时间,想着明天阅读的时候随手修改些,从昨天到今天真的很煎熬,速度太慢了,严重影响了阅读体验。
到今天实在扛不住了,5500个呀,啥时候是个头,有了前两天手工的采集年龄经验,今天实在不行一个一个手工采集了,突然想到丢给WorkBuudy,依然不让我失望,他开始尝试访问,然后就给了方案。
从尝试到有方案到优化,不到一小时5500个网站的标题统一了、网站年龄也有了,这速度以前想都不敢想,这其中WB尝试了很多次,即使网站各种限制抓取,WB都能有方法突破。
最开始是让我执行代码,这肯定不行了,让他写成功能,且把旧数据以及未来的数据都考虑到,让处理自动起来了,后续就省事了。一些截图:
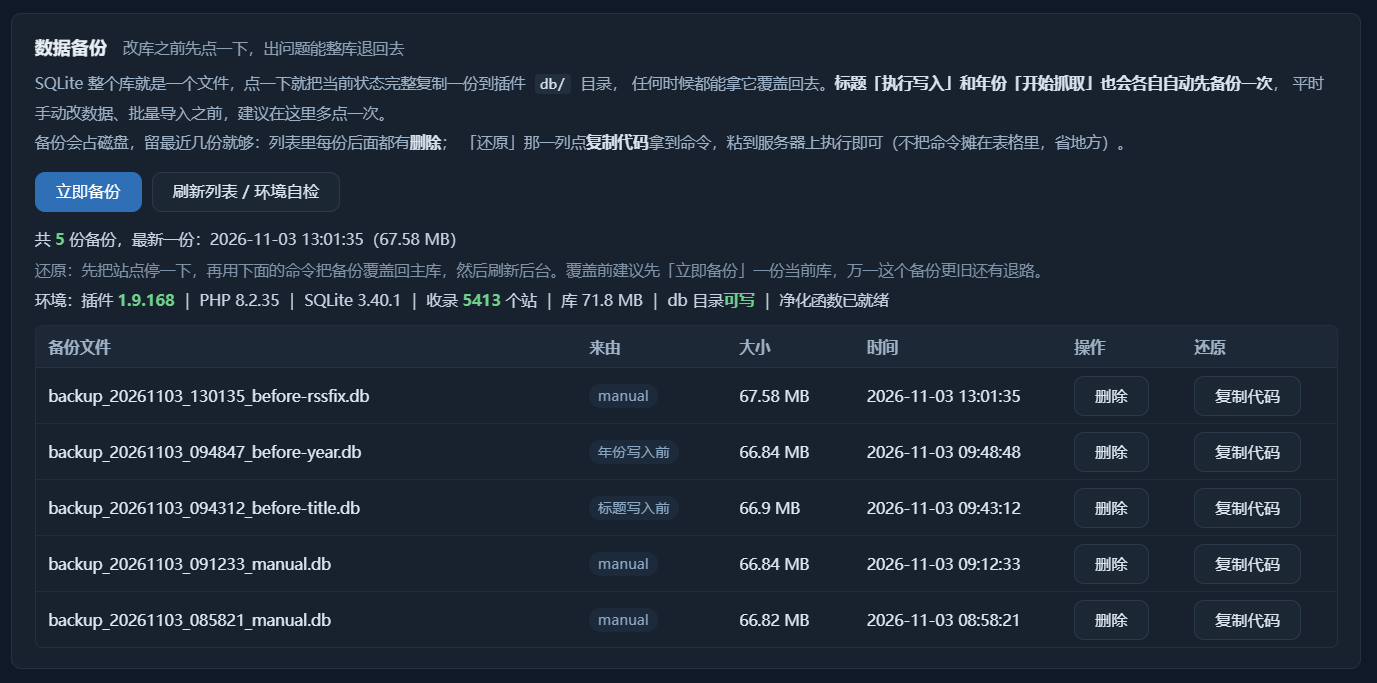
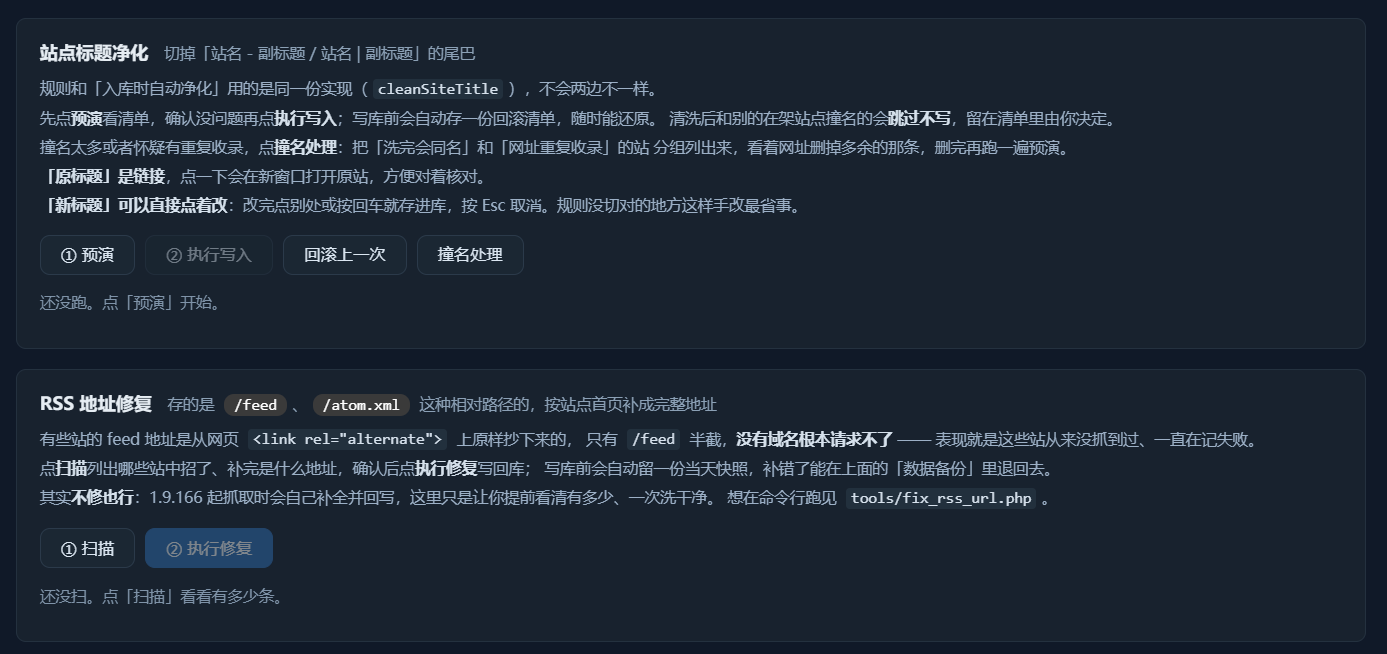
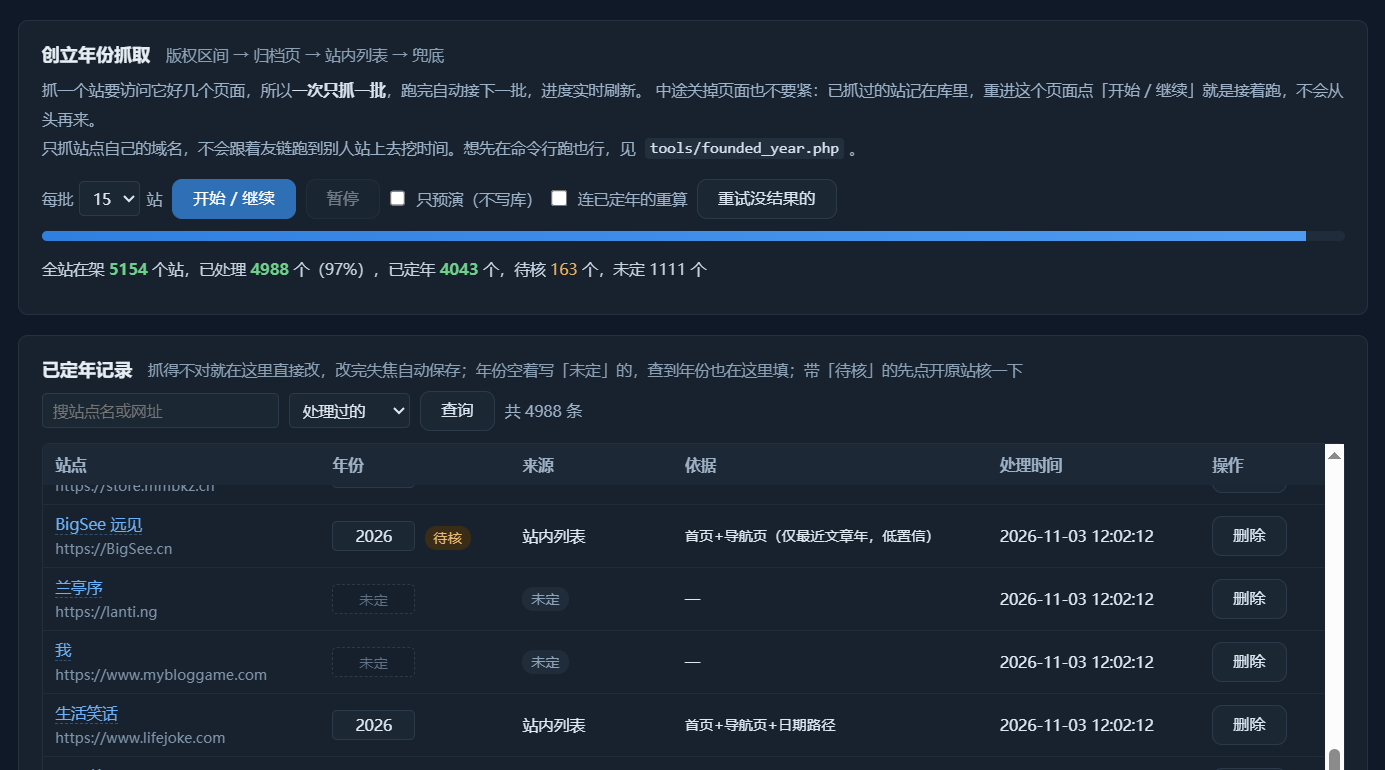
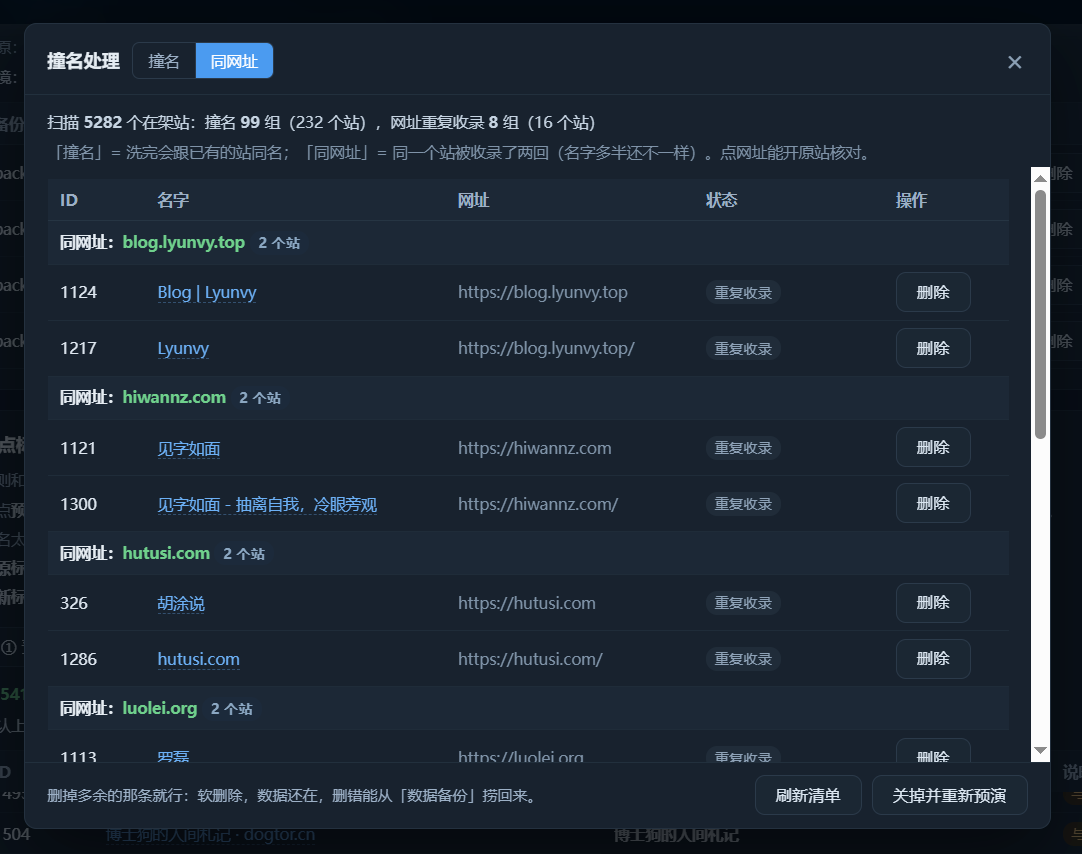
这几天的RSS折腾看似没啥用,其实用处极大,正在改变我许多老旧的思维和习惯,不停的尝试AI的上限,后续再其他方面的工作和生活肯定会带来很大的影响。
今天边工作边给几个独立页面新增了RSS功能,同时还整了个精彩热议功能,相当有意思的功能,抓取大家评论多的页面,然后展示再精彩热议页面,当然内容没抓取,因为我还是坚持让流量回到作者的底线,用评论来给大家带去流量。这个功能很有创新,抓取的时候自动检测大家的评论区,采集大家评论区的评论人,判断网址是否在库,不在库进入采集入库流程,一套的流程循环起来了,自动来。